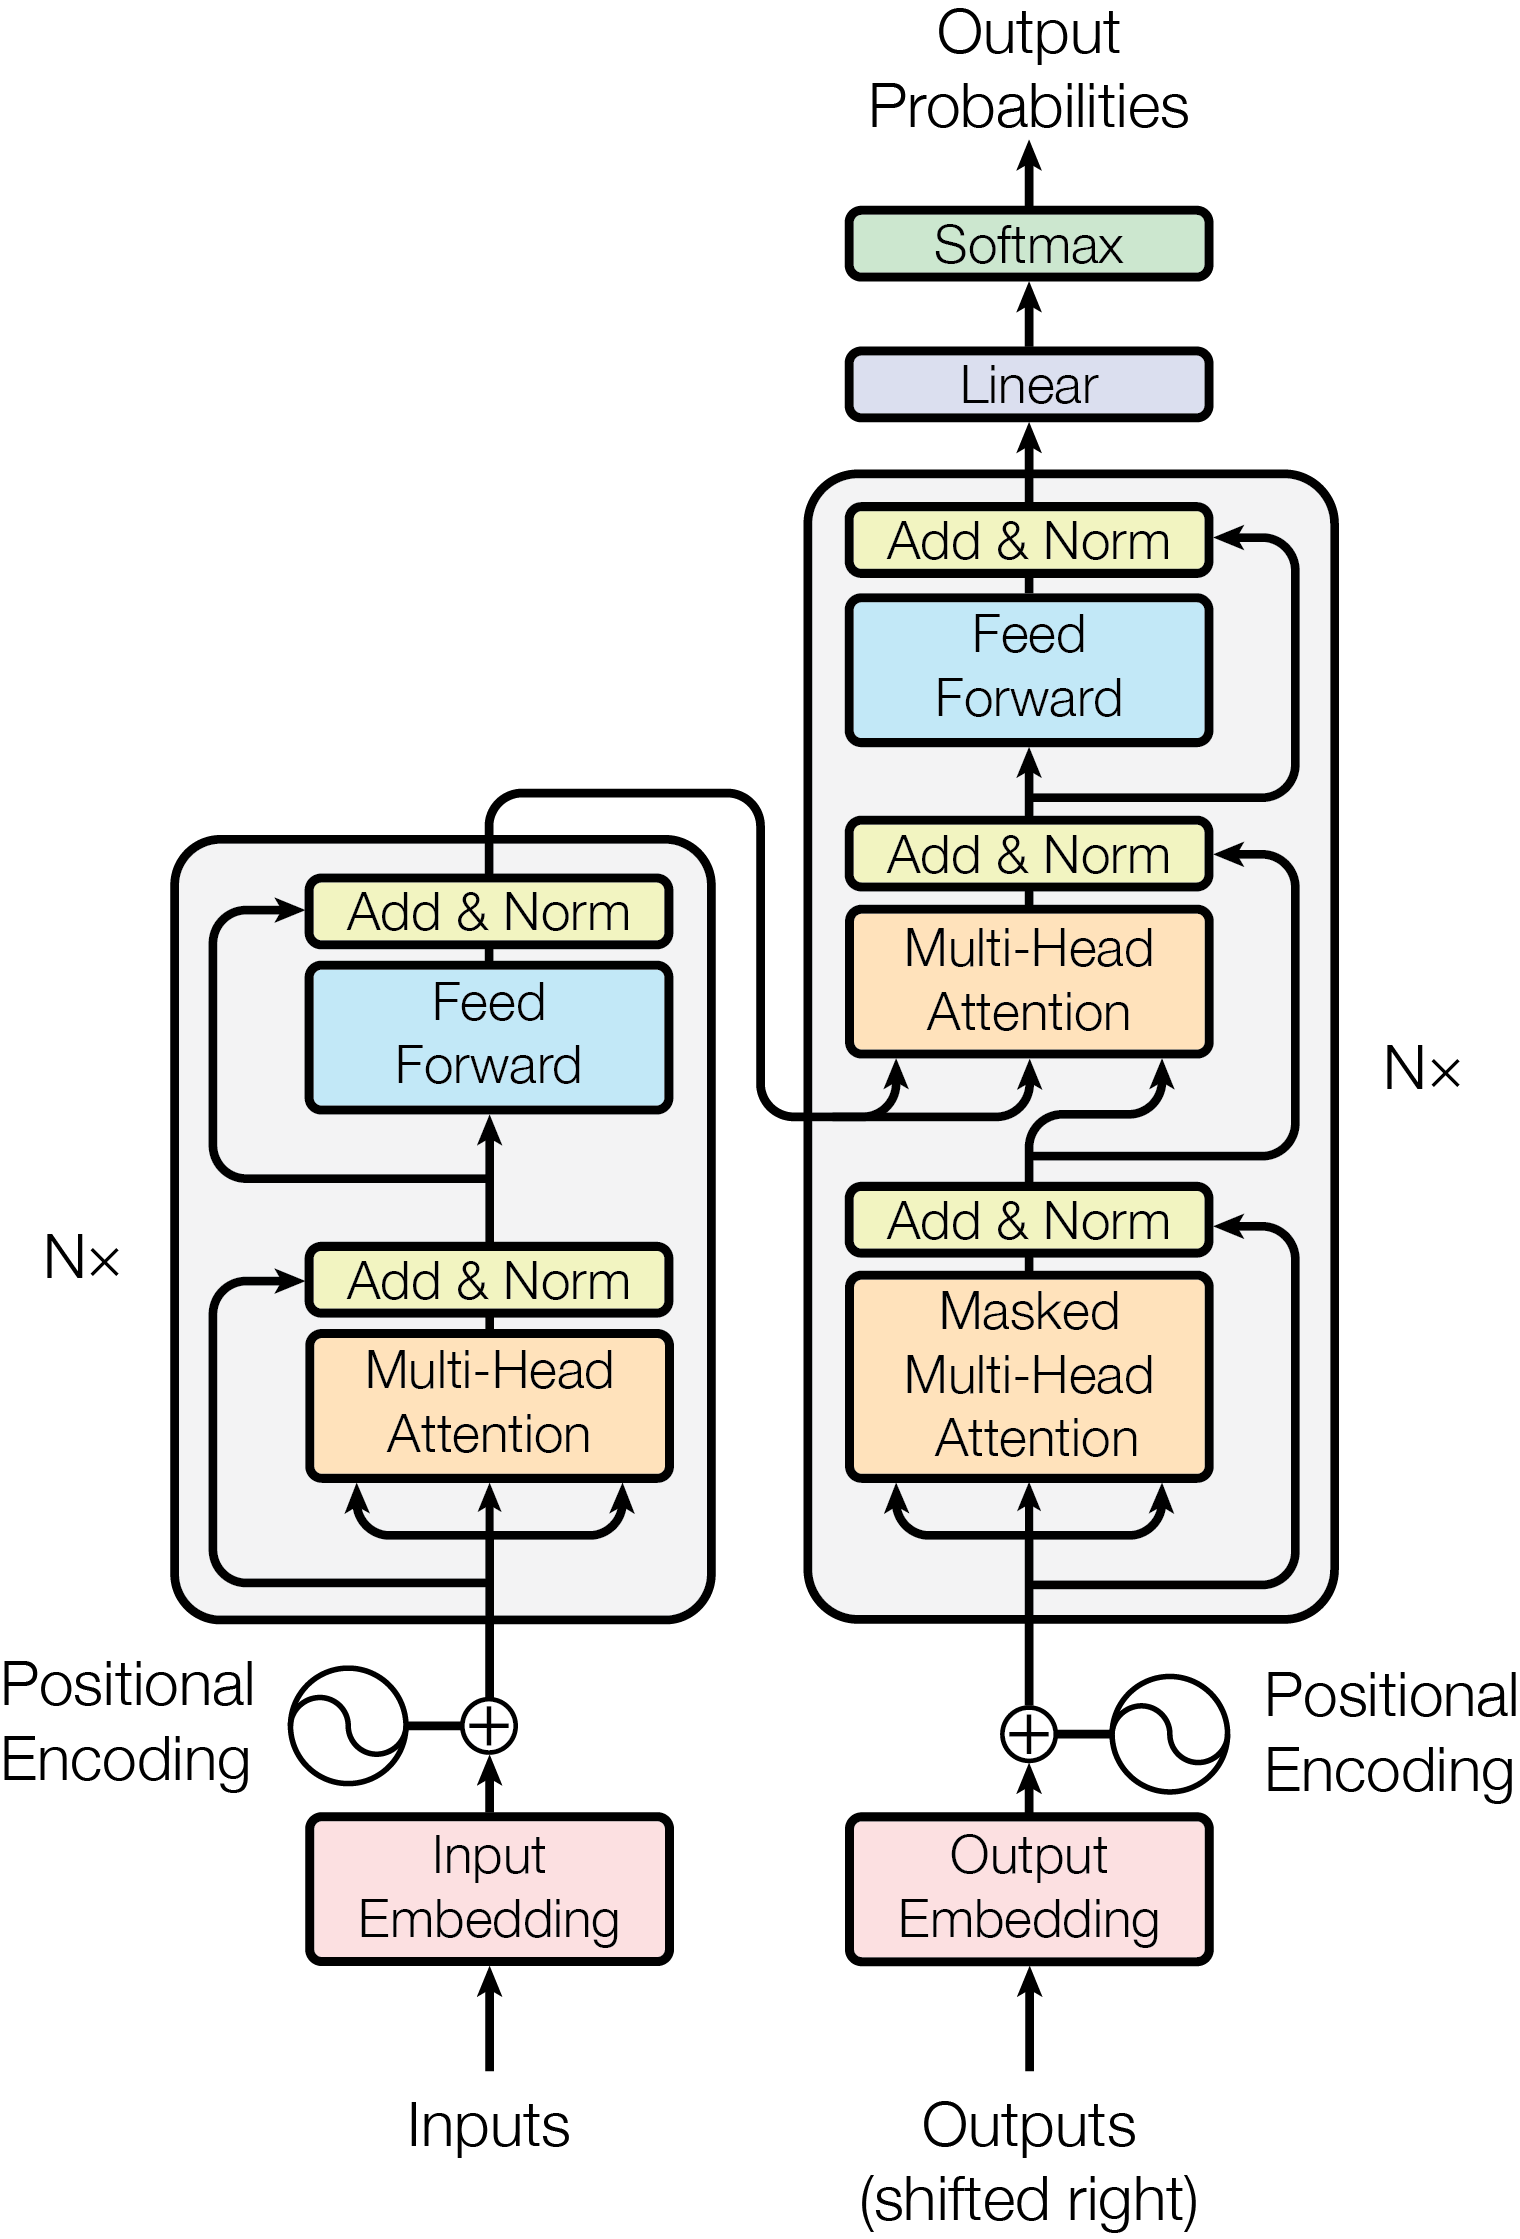
Transformer 最初是为序列到序列任务设计的:读入源序列,再逐个预测目标序列。它把“读懂输入”和“生成输出”分给两组堆叠的层。阅读 《Attention Is All You Need》图 1时,从左下角沿编码器往上走,再从右下角沿解码器往上走;中间横向箭头表示解码器读取编码器的输出。

输入先有内容,也要有顺序
词元 ID 先查 embedding 表,得到 X ∈ R^(B×S×D);B 是批大小,S 是源序列长度,D = dmodel。注意力本身只比较向量,不知道第一个词和最后一个词的先后。原论文把位置向量加到输入 embedding 上:H⁰ = Embed(tokens) + PE,相加的两项都是 [B, S, D]。论文采用不同频率的正弦、余弦位置编码,也讨论了可学习的位置表示。位置编码提供位置信息,并不会替代因果掩码。
编码器:让每个位置读完整输入
每个编码器层有两个子层:多头 self-attention 和逐位置前馈网络(FFN)。前者让一个位置读取同一源序列中的其他位置;后者对每个位置独立地使用同一组参数,把 D → Dff → D,原论文中间使用 ReLU:
FFN(x) = ReLU(x W₁ + b₁) W₂ + b₂
W₁: [D, Dff],W₂: [Dff, D]
每个子层外有残差连接和 LayerNorm,故层的输入输出均为 [B, S, D],便于继续堆叠。原论文图 1 使用的是 post-norm:LayerNorm(x + Sublayer(x))。后来的实现也常用先归一化的 pre-norm;读代码时要分清,不能把两种顺序当成同一个公式。编码器可用 padding mask 跳过补齐的键,但通常不加未来位置的因果限制。
解码器:先看历史,再看输入
目标序列长度记为 T。一个解码器层按顺序执行三个子层:
- 带因果掩码的 self-attention:第
t个位置只能看见目标序列中≤ t的位置,输出[B, T, D]。 - Encoder–decoder attention:查询来自解码器
[B, T, D],键和值来自编码器输出[B, S, D],注意力矩阵是[B, H, T, S]。这一步使当前生成位置能读取整个源序列。 - 逐位置 FFN:继续变换每个位置的表示,输出仍为
[B, T, D]。
三处都带残差和归一化。最后把 [B, T, D] 投影到词表大小 V,得到每个位置的 logits [B, T, V]。训练时把目标序列右移一位作为解码器输入:例如输入 <bos> 我 喜欢,标签是 我 喜欢 机器学习 的对应前缀。因果掩码保证模型即使并行计算所有目标位置,也看不到待预测词;推理时才逐步把新词追加到输入中。
用 PyTorch 对齐张量与掩码
以下是一个独立的形状示例,展示连接方式而非完整训练脚本。代码用随机 ID 占位;真实训练应使用分词器输出的 src_ids,并将目标序列右移,组成以 <bos> 开头的 tgt_in。位置编码、损失函数与生成循环需另行加入。
import torch
from torch import nn

B, S, T, D, V = 2, 7, 5, 128, 1000
pad_id = 0
bos_id = 1
src_ids = torch.randint(1, V, (B, S))
tgt_in = torch.randint(1, V, (B, T))
tgt_in[:, 0] = bos_id

src_embed = nn.Embedding(V, D, padding_idx=pad_id)
tgt_embed = nn.Embedding(V, D, padding_idx=pad_id)
model = nn.Transformer(
    d_model=D, nhead=4, num_encoder_layers=2,
    num_decoder_layers=2, batch_first=True,
)
to_vocab = nn.Linear(D, V)

src = src_embed(src_ids)             # [B, S, D];实际模型还需加位置编码
tgt = tgt_embed(tgt_in)              # [B, T, D];实际模型还需加位置编码
future = torch.triu(torch.ones(T, T, dtype=torch.bool), diagonal=1)
src_pad = src_ids.eq(pad_id)          # [B, S],True 表示 padding
tgt_pad = tgt_in.eq(pad_id)           # [B, T]
hidden = model(
    src, tgt, tgt_mask=future,
    src_key_padding_mask=src_pad,
    tgt_key_padding_mask=tgt_pad,
    memory_key_padding_mask=src_pad,
)
logits = to_vocab(hidden)            # [B, T, V]
这里的 future 阻止目标位置偷看未来;src_pad、tgt_pad 阻止读取补齐的键。编码器输出作为 cross-attention 的 memory,因此还要传 memory_key_padding_mask=src_pad。在 nn.Transformer 中布尔掩码的 True 表示禁止关注,与 torch.nn.functional.scaled_dot_product_attention 的布尔掩码语义相反。复制代码跨 API 使用前,要先检查这个细节。实际训练时还应在损失中忽略 padding 标签,并确保每个查询至少有一个可读键。
把整张图记成一条信息流即可:源序列经编码器形成 memory;目标前缀经带因果掩码的解码器读取自身历史和 memory,再预测下一个词。 只保留左半边可得到编码器式模型;只保留带因果掩码的目标侧可用于自回归语言建模,但那已是针对任务改造的结构,不是原论文完整的编码器–解码器模型。
延伸阅读: Attention Is All You Need(原论文,§3、图 1);PyTorch nn.Transformer 文档。